Ljudannotering och talmärkningstjänster för röst-AI
Produktionsklara ljuddataset på över 150 språk – talmärkning, transkription, talardagbok och akustisk händelsemärkning, levererat av specialiserade annotatörer
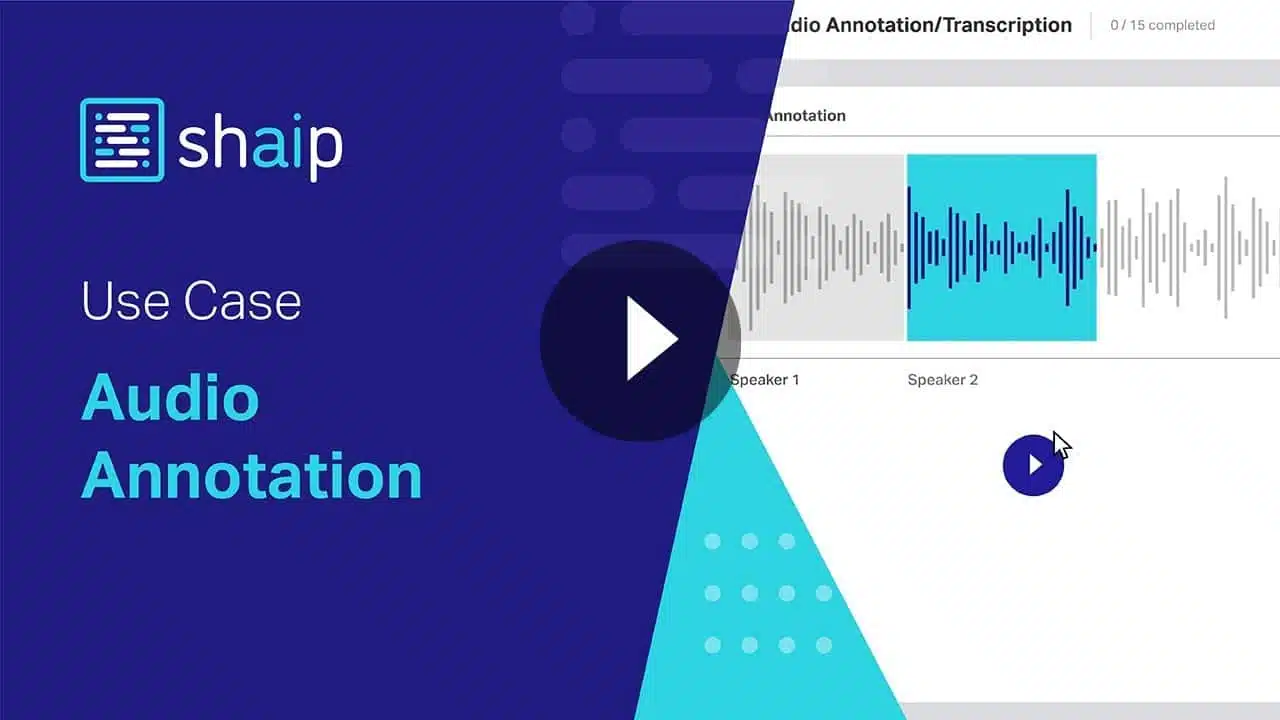
Vad är ljudkommentarer?
Ljudannotering är processen att märka talade ord, ljud, talare, känslor och akustiska händelser i en ljudfil så att maskininlärningsmodeller – automatisk taligenkänning (ASR), röstassistenter, konversations-AI och generativ röst-AI – kan tolka verkliga ljud. Shaip levererar ljudannotering som en hanterad tjänst på över 150 språk, och kombinerar utbildade lingvister med AI-assisterade verktyg och ett 6-Sigma-kvalitetsramverk.
Vår expertis
Anpassad ljudmärkning/kommentar är inte längre en avlägsen dröm
Tal- och ljudmärkningstjänster har varit Shaips starka sida sedan starten. Utveckla, träna och förbättra konversations-AI, chatbots och taligenkänningsmotorer med våra toppmoderna ljud- och talmärkningslösningar. Vårt nätverk av kvalificerade lingvister över hela världen med ett erfaret projektledningsteam kan samla timmar av flerspråkigt ljud och kommentera stora mängder data för att träna röstaktiverade applikationer. Vi transkriberar också ljudfiler för att extrahera meningsfulla insikter som är tillgängliga i ljudformat. Välj nu den teknik för märkning av ljud och tal som passar ditt mål bäst och lämna brainstorming och tekniska detaljer till Shaip.
Taltranskription och tidsstämpling
Ordagrann, icke-ordagrann och fonetisk transkription med talar-ID:n och tidsstämplar på ordnivå, redo för ASR- och STT-modellträning. Utdata i JSON, TextGrid, ELAN, CTM och anpassade scheman, för datamängder i produktionsklass.
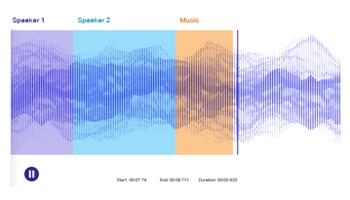
Talmärkning
Tal- eller ljudmärkning är en vanlig annoteringsteknik som gäller att skilja ljud och märkning med specifika metadata. Kärnan i denna teknik innefattar ontologisk identifiering av ljud från ett ljudstycke och att korrekt kommentera dem för att göra utbildningsdatauppsättningarna mer inkluderande
Akustisk händelse och ljudklassificering
Märker icke-talande ljud – larm, hosta, skottlossning, maskinljud, trafik, fotsteg – för igenkänning av omgivningsljud, övervakning, prediktivt underhåll och klinisk AI i andningsvägarna. En eller flera etiketter, med anpassade taxonomier anpassade till klientscheman och AudioSet-kompatibla exporter.
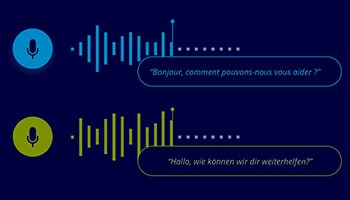
Flerspråkig ljudannotering
Annoterare för modersmålstalare på över 150 språk och dialekter – inklusive språk med låga resurser och indiska språk – som hanterar kodomkopplade inspelningar, regionala accenter och kulturellt specifik terminologi. Användbart där globala implementeringar av röst-AI behöver språklig täckning som leverantörer som endast använder engelska eller använder en enda språkgrupp inte kan upprätthålla.
Naturligt språkligt yttrande (NLU) och avsiktsannotering
Intent-, entitets- och slot-taggning på talat språk, med dialekt-, semantik- och sentimentlager. Datasetformatet driver chattrobotar, IVR-system, röstassistenter och generativa röstagenter som är tränade att hantera verkliga samtal, inklusive kodväxling mellan två eller flera språk inom ett enda yttrande.
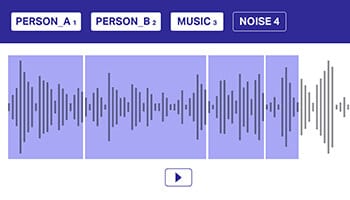
Multi-Label
anteckning
Att kommentera ljuddata genom att använda flera etiketter är viktigt för att hjälpa modeller att skilja överlappande ljudkällor. I detta tillvägagångssätt kan en ljuddatauppsättning tillhöra en eller flera klasser, som måste uttryckligen överföras till modellen för bättre beslutsfattande.
Talardagbok och identifiering
Gränsdetektering som delar upp långa inspelningar – callcentersamtal, kliniska konsultationer, möten – i homogena segment per talare. Inkluderar kön, åldersgrupp och språkmärkning där användningsfallet kräver det, vilket hjälper modeller att korrekt attribuera tal i miljöer med flera talare.
Fonetisk transkription
Till skillnad från vanlig transkription som omvandlar ljud till en sekvens av ord, noterar en fonetisk transkription hur ord uttalas och representerar visuellt ljuden med fonetiska symboler. Fonetisk transkription gör det lättare att notera skillnaden i uttal av samma språk i flera dialekter.
Ljudannotering för generativ och multimodal AI
Specialistmärkning för generativ röst-AI, RLHF för ljudutgångar, multimodal träningsdata som kombinerar tal med text eller video, och förberedelse av TTS-dataset. Inkluderar ljudpar med snabba svar, preferensrankning och stil-/tonetiketter för finjustering av konversations- och röstkloningsmodeller.
Typer av ljudklassificering
Akustikdataklassificering
Ljud klassificeras efter inspelningsmiljö – skolor, hem, kaféer, kollektivtrafik, fordon – för att träna taligenkänning, virtuella assistenter, ljudbibliotek och övervakningssystem som behöver känna igen sammanhang, inte bara ord.
Miljöljudsklassificering
Ljudhändelser som inte är musik eller tal – tutningar, sirener, skottlossning, glas som krossas, barn som leker, maskiner – är märkta för säkerhets-AI, prediktivt underhåll och implementeringar av smarta städer där mönsterbaserad klassificering inte gäller.
Musikklassificering
Genre-, instrument-, stämnings-, tempo- och ensembleetiketter för musikbibliotek, rekommendationssystem, upphovsrättsdetektering och innehållsmoderering. Inkluderar fleretikettstaggning för spår som spänner över genrer eller stämningar.
Klassificering av naturligt språkuttalande
Avsikt och mening extraheras på yttrandenivå – dialekt, semantik, betoning, ton – för att driva chattrobotar, röstassistenter och konversations-AI som reagerar på hur något sägs, inte bara vad som sägs.
Tal- och ljudanteckningsverktyg som drivs av Human Intelligence
Trots omfattande datainsamling förväntas inte maskininlärningsmodeller förstå kontext och relevans på egen hand. Även om självlärande NLP-modeller skulle kunna användas, skulle den inledande fasen av utbildning, eller snarare handledd inlärning, kräva att de matas med ljudresurser i metadatalager.
Det är här Shaip kommer in i bilden genom att göra toppmoderna datamängder tillgängliga för att träna AI- och ML-uppsättningar, enligt standardanvändningsfall. Vår professionella personal och ett team av experter på annotering är alltid på jobbet för att märka och kategorisera taldata i relevanta databaser.
- Berika bearbetningsinställningar för naturligt språk med granulär ljuddata
- Upplev personliga och fjärranmälningsanläggningar
- Utforska de bästa brusreducerande teknikerna som annotering med flera etiketter, hands-on
Anledningar att välja Shaip som din pålitliga Audio Annotation Partner
Personer
Dedikerade och utbildade team:
- 30,000+ medarbetare för dataskapande, märkning och kvalitetssäkring
- Godkänd projektledningsteam
- Erfaren produktutvecklingsteam
- Talent Pool Sourcing & Onboarding Team
Behandla
Högsta processeffektivitet säkerställs med:
- Robust 6 Sigma Stage-Gate-process
- Ett dedikerat team med 6 Sigma-svarta bälten - Viktiga processägare och kvalitetskrav
- Kontinuerlig förbättring och återkopplingsslinga
plattform
Den patenterade plattformen erbjuder fördelar:
- Webbaserad end-to-end-plattform
- Oklanderlig kvalitet
- Snabbare TAT
- Sömlös leverans
Varför ska du lägga ut märkning / annotering av ljuddata?
Dediker team
Det uppskattas att datavetenskapsmän lägger över 80% av sin tid på datastädning och dataförberedelse. Med outsourcing kan ditt team av datavetenskapare fokusera på att fortsätta utvecklingen av robusta algoritmer som lämnar den tråkiga delen av jobbet åt oss.
Bättre kvalité
Dedikerade domänsexperter som kommenterar dag in och dag ut kommer-vilken dag som helst-att göra ett överlägset jobb jämfört med ett team, som måste rymma annoteringsuppgifter i sina upptagna scheman. Det behöver inte sägas att det ger bättre utdata.
Skalbarhet
Även en genomsnittlig Machine Learning (ML) -modell skulle kräva märkning av stora bitar data, vilket kräver att företag drar in resurser från andra team. Med datakommentarer som vi, erbjuder vi domänexperter som dedikerat arbetar med dina projekt och enkelt kan skala verksamheten när ditt företag växer.
Eliminera intern fördom
Anledningen till att AI -modeller misslyckas är att team som arbetar med datainsamling och annotering oavsiktligt introducerar partiskhet, snedställer slutresultatet och påverkar noggrannheten. Datanoteringsleverantören gör dock ett bättre jobb med att kommentera data för förbättrad noggrannhet genom att eliminera antaganden och fördomar.
Erbjudna tjänster
Expert insamling av bilddata är inte all-hands-on-deck för omfattande AI-inställningar. På Shaip kan du till och med överväga följande tjänster för att göra modeller betydligt mer utbredda än vanligt:
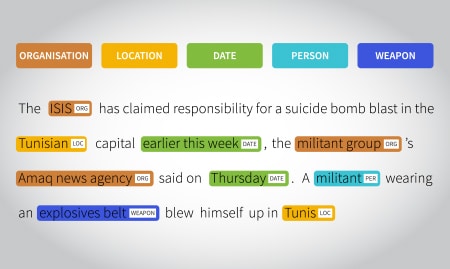
Textanteckningstjänster
Vi är specialiserade på att göra textdataträning redo genom att kommentera uttömmande datamängder, använda enhetsannotering, textklassificering, sentimentannotering och andra relevanta verktyg.
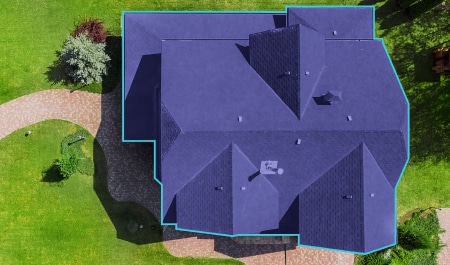
Bildannoteringstjänster
Vi är stolta över att märka, segmenterade bilddatauppsättningar för att träna kräsna datorsynmodeller. Några av de relevanta teknikerna inkluderar gränsigenkänning och bildklassificering.
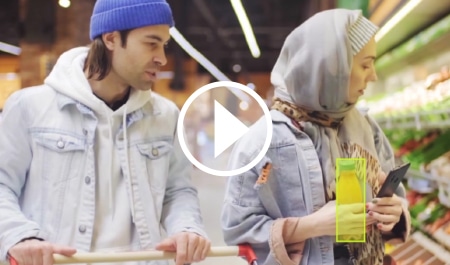
Videokommentartjänster
Shaip erbjuder avancerade videomärkningstjänster för utbildning av datorseendemodeller.
Syftet här är att göra datamängder användbara med verktyg som mönsterigenkänning, objektdetektering och mer.
Rekommenderade resurser
Köparhandboken
Köparguide för konversations-AI
Chatboten du pratade med körs på ett avancerat konversations-AI-system som är tränat, testat och byggt med hjälp av massor av taligenkänningsdataset
offer~~POS=TRUNC
Taldatainsamlingstjänster för dina AI:er
Shaip erbjuder end-to-end tal-/ljuddatainsamlingstjänster på över 150+ språk för att möjliggöra röstaktiverad teknik för att tillgodose en mångfald av publik över hela världen.
Blogg
Vad är ljud-/talkommentar med exempel
Vi har alla ställt Alexa (eller andra röstassistenter) några öppna frågor. Alexa, är närmaste pizzaställe öppet? Alexa, vilken restaurang på min plats erbjuder gratis leverans till min adress?
Utvalda klienter
Stärka team för att bygga världsledande AI-produkter.
Få experter på ljudkommentarer ombord.
Förbered nu väl undersökta, granulära, segmenterade och multi-märkta ljuddataset för intelligenta AI:er
Vanliga frågor (FAQ)
1. Vad är ljudannotering, och hur skiljer det sig från transkription?
2. Vilka typer av ljudannoteringar erbjuder Shaip?
3. Vilka branscher och användningsområden stöder Shaips ljudannotering?
4. Hur säkerställer Shaip noggrannhet och kvalitet i ljudannoteringar?
5. Vilka språk täcker Shaips ljudannoteringsteam?
6. Är Shaips ljudannoteringstjänst kompatibel med HIPAA, GDPR och ISO 27001?
7. Hur hanterar Shaip ljudannotering för generativ AI och stora röstmodeller?
8. Kan Shaip fungera med ljudannotering för bullriga, verkliga eller domänspecifika miljöer?
9. Hur förbättrar ljudannotering AI-drivna taligenkänningssystem?
Den tillhandahåller märkta data som hjälper system att identifiera ord, accenter och avsikt, vilket förbättrar transkription och förståelse.
10. Vilka är utmaningarna med att annotera flerspråkiga ljuddataset?
Utmaningarna inkluderar hantering av accenter och dialekter. Shaip hanterar detta med globala lingvister och skalbara processer.