Röstigenkänning är en teknik som identifierar och autentiserar en person baserat på deras rösts unika egenskaper, medan dess nära syskon, taligenkänning, omvandlar talade ord till text eller kommandon. Tillsammans driver de allt från smarta högtalare och kontroller i bilen till banksäkerhet och klinisk dokumentation. Den globala marknaden för röst- och taligenkänning värderades till 20.25 miljarder dollar år 2023 och förväntas nå 53.67 miljarder dollar år 2030, med en årlig tillväxttakt på 14.6 % (Grand View Research, 2024) – och röstigenkänning är det snabbast växande funktionssegmentet inom det (Grand View Research, 2024).
Den här guiden förklarar hur röstigenkänning fungerar, var det används, dess fördelar och begränsningar, och de förändringar som 2026 omformar området.
Key Takeaways
- Röstigenkänning identifierar vem som talar; taligenkänning förstår vad som sägs.
- System analyserar tonhöjd, frekvens, accent och kadens för att skapa ett unikt röstavtryck.
- De främsta tillämpningarna: säkerhet och biometri, röstaktiverade enheter, kundtjänst, sjukvård och fordonsindustrin.
- Noggrannheten beror starkt på mångsidig, väldefinierad träningsdata över olika accenter och språk. Att skaffa den i stor skala är där det är redo att användas. taldatauppsättningar spara teamen månader av insamling.
- Trenderna för 2026 inkluderar tal-till-tal AI-modeller, bearbetning på enheter och försvar mot djupförfalskningar av röster.
Marknadsstorlek: På mindre än 20 år har röstigenkänningstekniken vuxit fenomenalt. Men vad har framtiden att erbjuda? År 2020 uppgick den globala marknaden för röstigenkänningsteknik till cirka 10.7 miljarder dollar. Den förväntas skjuta i höjden till 27.16 miljarder dollar år 2026 med en årlig tillväxttakt på 16.8 % från 2021 till 2026.
Vad är teknik för röstigenkänning?
Fältet kan spåras tillbaka till system på 1950-talet som bara kunde känna igen en handfull siffror. Statistiska modeller och senare djupinlärning förvandlade dessa tidiga experiment till de ständigt lyssnande assistenter och säkra röstautentiseringssystem som används av miljarder människor idag.
Röstigenkänning – Fördelar & Nackdelar
Hur fungerar röstigenkänning?
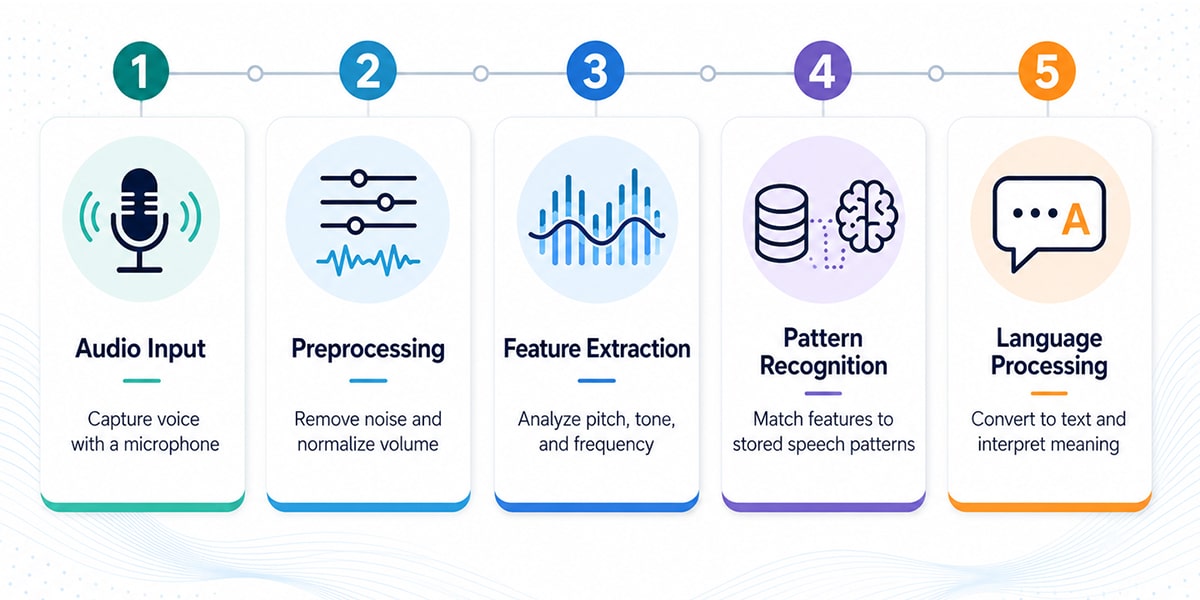
Ljudingång : Processen börjar med att spela in ljudingången med en mikrofon.
Förbehandling : Ljudsignalen rensas upp genom att brus tas bort och volymen normaliseras.
Funktionsextraktion : Systemet analyserar ljudet för att extrahera viktiga funktioner som tonhöjd, ton och frekvens.
Mönsterigenkänning : De extraherade funktionerna jämförs med kända talmönster som lagras i en databas.
Språkbehandling : De igenkända mönstren omvandlas till text, och algoritmer för naturlig språkbehandling (NLP) tolkar betydelsen.
Användningsfall för röstigenkänning
Röstigenkänningsteknik har ett brett utbud av tillämpningar inom olika områden. Här är några viktiga användningsfall:
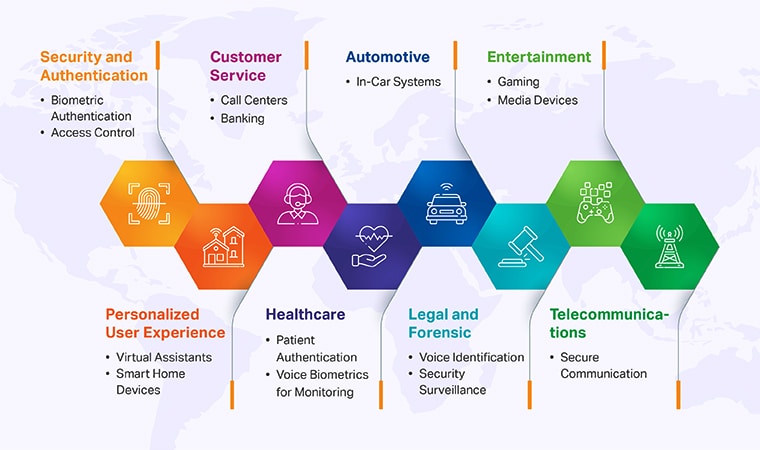
- Säkerhet och verifiering:
- Biometrisk autentisering: Används i smartphones och andra enheter för att låsa upp skärmar och verifiera användarens identitet.
- Åtkomstkontroll: Säkrar åtkomst till byggnader, säkra områden och konfidentiell information genom att känna igen auktoriserad personal.
- RöstigenkänningsprodukterExempel inkluderar smarta hemenheter och säkerhetssystem som använder röstigenkänning för handsfree-styrning och förbättrad säkerhet.
- Personlig användarupplevelse:
- Virtuella assistenter: Anpassar svar och åtgärder baserat på användarens röst, vilket ger en mer personlig interaktion.
- Smarta hem enheterKänner igen olika familjemedlemmars röster för att skräddarsy inställningar och preferenser för varje individ. Var och en av dessa handsfree-enheter utlöses av ett väckningsord – och att skapa en korrekt, märkesspecifik röst för din produkt kräver anpassning. wake word träningsdata.
- RöstskrivningAnvänds som ett produktivitetsverktyg för datainmatning och automatisering, vilket förbättrar effektivitet och noggrannhet i olika miljöer.
- Kundservice:
- Call Centers: Identifierar kunder med deras röst, vilket möjliggör personlig service och minskar behovet av upprepad identitetsverifiering.
- Banking: Verifierar kunder under telefonbanktransaktioner för säker och effektiv service.
- Programvara för tal till textOmvandlar talat språk till skriven text, vilket förbättrar effektivitet, kundservice och noggrannhet i kommunikationen.
- Sjukvård:
- Patientautentisering: Bekräftar patientens identitet i telehälsotjänster och elektroniska journaler.
- Röstbiometri för övervakning: Övervakar patienter med tillstånd som depression genom att analysera förändringar i röstmönster.
- Doktorns virtuella assistent: Konverterar läkarens tal till textanteckningar så att läkaren kan se och analysera fler patienter under dagen.
- Applikationer från tredje partMedicinska assistenter och vårdverktyg integrerar röstigenkänning för förbättrad funktionalitet.
- Bil:
- In-Car Systems: Känner igen förarens röst för att justera preferenser, komma åt navigering och styra infotainmentsystem utan manuell inmatning.
- Handsfree-upplevelse: Svara på telefonsamtal, byt låt, svara på meddelanden eller få riktning utan att behöva lämna ratten; detta ökar inte bara säkerheten på vägen utan ger också bättre körupplevelse.
- Juridisk och kriminalteknisk:
- Röstidentifiering: Används i juridiska utredningar för att identifiera talare i ljudinspelningar.
- Säkerhetsövervakning: Förbättrar säkerhetsåtgärder genom att identifiera individer genom röst i övervakningssystem.
- DomstolsrapporteringAvancerad röstigenkänning används för korrekt juridisk transkription under domstolsförhandlingar och vittnesmål, vilket förbättrar effektiviteten och noggrannheten jämfört med traditionella domstolsrapporteringsmetoder.
- Underhållning:
- Gaming: Anpassar spelupplevelser genom att känna igen spelarnas röster.
- Medieenheter: Identifierar användare för att anpassa innehållsrekommendationer och profiler på streamingenheter.
- Telekommunikationer:
- Säker kommunikation: Säkerställer säkra kommunikationskanaler genom att verifiera identiteten på deltagare i konfidentiella samtal.
- RöstgränssnittMöjliggör naturliga, konversationsbaserade interaktioner i generativ AI och smarta enheter, vilket gör användarupplevelserna mer intuitiva.
- Flera enheter och mobila enheterRöstigenkänningstekniken fungerar sömlöst på flera enheter, inklusive mobila enheter och Android-telefoner, vilket stöder produktivitet och användarupplevelse när du är på språng.
- Arbete med igenkänningsprogramvaraModern igenkänningsprogramvara fungerar genom att stödja olika språk, erbjuda flerspråkigt stöd och ge kompatibilitet med mobila enheter och olika plattformar för röststyrning.
- Röstigenkänningsprogramvara fungerarRöstigenkänningsprogramvara fungerar på olika plattformar, stöder flera språk och integreras med tredjepartsapplikationer för förbättrad funktionalitet.
- Stöd för olika språkModerna röstigenkänningssystem kan växla mellan olika språk, dialekter och accenter, vilket gör dem mångsidiga för global användning.
Exempel på teknik för röstigenkänning
- Apple Siri: Föreställ dig att ha en kvick, kunnig vän i fickan, alltid redo att hjälpa. Det är Siri för dig. Oavsett om du rusar till ett möte och behöver skicka ett snabbt sms, eller om du är djupt nere i kakdegen och behöver ställa in en timer, så finns Siri där, känner igen din röst och svarar med en touch av personlighet. Det är som att ha en personlig assistent som känner dig så väl, de kan nästan avsluta dina meningar.
- Amazon Alexa: Föreställ dig att gå in i ditt hem efter en lång dag och säga "Alexa, jag är hemma." Plötsligt börjar din favoritspellista för avslappning att spelas upp, ljuset dämpas till din föredragna kvällsmiljö och Alexa påminner dig om det där programmet du tänkte titta på. Det är som att ditt hem ger dig en personlig, tröstande kram varje gång du kommer tillbaka.
- Google-assistent: Tänk på Google Assistant som din allvetande kompis. Oavsett om du undrar över vädret, behöver avgöra en vänlig debatt eller vill kontrollera ditt smarta hem, så finns det där, känner igen din röst och skräddarsyr svaren just för dig. Det är som att ha en supersmart vän som alltid är glad över att hjälpa och aldrig tröttnar på dina frågor.
- Nuance Dragon NaturallySpeaking: Föreställ dig att du kan gjuta dina tankar på papper så snabbt du kan tala dem. Det är magin med Dragon NaturallySpeaking. För en författare som skapar sin nästa bästsäljare eller en läkare som uppdaterar patientjournaler är det som att ha en supereffektiv, aldrig tröttsam transkriberare som förstår varje ord, accent och nyans i din röst. Det är inte bara att skriva – det befriar dina tankar.
- Microsoft Cortana: Cortana är som att ha en personlig arrangör som alltid ligger steget före. Tänk dig själv en hektisk måndagsmorgon, och Cortana slår in: "Baserat på din röst låter du lite stressad. Ska jag boka om dina mindre brådskande möten till senare i veckan?” Det handlar inte bara om att hantera ditt schema; det handlar om att ha en digital allierad som förstår nyanserna i din röst och hjälper till att göra din dag smidigare.