
Multimodal AI: Den kompletta guiden till träningsdata, modeller och användningsfall
Ändå underskattar de flesta team vad som faktiskt krävs för att bygga upp dessa data. De behandlar det som ett märkningsarbete. Det är det inte. Det är en koordineringsutmaning: flera datatyper samlas in synkroniserat, kommenteras med konsekventa scheman och justeras över olika modaliteter innan en modell ens ser ett enda exempel.
På Shaip, numera en del av Ubiquity-ekosystemet, arbetar vi med AI-team som bygger datamängder för text, tal, bild, video, sensorer och medicinska bildmodaliteter. Mönstren som skiljer högpresterande multimodala modeller från dyra misslyckanden beror på tidiga beslut om datakvalitet – beslut som den här guiden guidar dig igenom.
I slutet av den här artikeln kommer du att förstå hur multimodala modeller lär sig, var de ledande modellerna år 2026 får sin fördel, vilka branscher som implementerar multimodal AI i stor skala med verifierade resultat, och exakt hur man skaffar de data som gör att det fungerar.
Vad är multimodal AI-träningsdata?
Multimodal AI-träningsdata är en strukturerad samling av parade eller sammanflätade indata från två eller flera datamodaliteter – såsom bilder med textundertexter, ljudinspelningar med transkript eller video med synkroniserade sensoravläsningar – som används för att träna AI-modeller att förstå och resonera tillsammans över dessa modaliteter. Till skillnad från unimodala dataset som tränar modeller på en enda datatyp kräver multimodala dataset tvärmodal anpassning: varje exempel måste förmedla en konsekvent betydelse över alla närvarande modaliteter.
Skillnaden är viktig i praktiken. En textbaserad modell som tränas på kliniska anteckningar lär sig att förutsäga diagnoser från ord. En multimodal modell som tränas på kliniska anteckningar och motsvarande bilddata kan upptäcka mönster som ingen av modaliteterna avslöjar på egen hand. Den kombinationen kräver en fundamentalt annorlunda metod för datainsamling, annotering och kvalitetskontroll.
Shaips multimodala utbildningsdatatjänster täcker sex kärnmodaliteter:
| Modalitet | Exempel | Primära användningsfall |
|---|---|---|
| text | Dokument, transkript, uppmaningar | Jurister, NLP, dokument AI |
| Bild | Foton, medicinska skanningar, satellitbilder | Datorseende, diagnostik |
| Audio | Tal, omgivningsljud, musik | ASR, sentiment, röst-AI |
| Video | Övervakning, produktdemonstrationer, medicinska procedurer | Åtgärdsigenkänning, övervakning |
| Sensor / LiDAR | IMU, radar, djupsensorer | Autonoma fordon, robotteknik |
| Medicinsk bildbehandling | CT, MRI, DICOM, röntgen | Klinisk AI, radiologi |
Unimodal vs. Multimodal i överblick:

Resan från single-mode till multimodal AI representerar ett betydande tekniskt framsteg. Tidiga AI-system var mycket specialiserade – bildklassificerare kunde identifiera objekt men inte förstå tillhörande textbeskrivningar, medan processorer för naturligt språk kunde analysera känslor men missade visuella signaler som gav avgörande sammanhang.
| Faktor | unimodal | multimodal |
|---|---|---|
| Datatyper | En (t.ex. endast text) | Två eller fler, i par |
| Modellexempel | GPT-4 (text), DALL-E (bild) | GPT-4o, Gemini 2.5, Llama 4 |
| Annoteringskomplexitet | Medium | Hög (konsekvens mellan olika modaliteter krävs) |
| Användningsområden | NLP-uppgifter, bildklassificering | Diagnostik, autonoma system, RAG |
| Behövlig datamängd | Hög | Mycket hög (10x+ mer per modalitet) |
Att förstå vad multimodal data är banar väg för att förstå hur modeller faktiskt använder den – och det är där de flesta team stöter på de första svåra överraskningarna.
Hur multimodala AI-modeller faktiskt lär sig
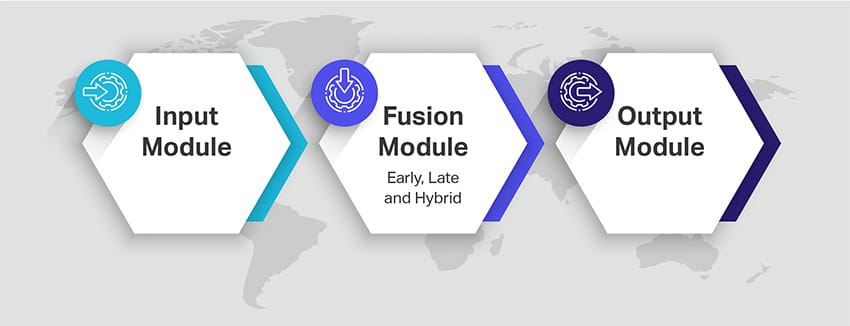
Varje multimodal modell körs på samma trestegspipeline: koda, sammanfoga, avkoda. Vad som händer i varje steg avgör vilken typ av träningsdata du behöver.
Steg 1: Kodare — Konvertera rådata till vektorer
Varje modalitet matas in genom en specialiserad kodare som omvandlar rå indata till numerisk inbäddning. En bildkodare (vanligtvis ett faltningsnätverk eller en bildtransformator) omvandlar en bild till en funktionsvektor. En textkodare, vanligtvis transformatorbaserad, gör detsamma för text. En ljudkodare bearbetar frekvensmönster från tal eller ljud.
Dessa kodare kan tränas från grunden, eller initieras från förtränade modeller som OpenAI:s CLIP , som lär sig ett delat inbäddningsutrymme för bilder och text genom att träna på 400 miljoner bildtextpar. Kvaliteten på dina träningsdata i detta skede avgör hur väl varje kodare generaliserar till din domän.
Steg 2: Fusion — Där modellen bygger tvärmodal förståelse
Fusion är där multimodalt lärande faktiskt sker. Modellen måste förena inbäddningar från olika modaliteter till en enda representation. Det finns fyra huvudstrategier:
- Tidig fusion: Råa indata kombineras före kodning. Enkelt, men känsligt för brus i alla modaliteter.
- Sen fusion: Varje modalitet kodas separat och kombineras i beslutslagret. Mer robust, men saknar potentiellt finkorniga tvärmodala relationer.
- Hybridfusion: En blandning av båda, där vissa modaliteter bearbetas gemensamt och andra oberoende av varandra.
- Dynamisk (adaptiv) fusion: Modellen lär sig att vikta varje modalitet baserat på inmatningskvalitet vid inferenstidpunkten. Om ljudet är brusigt nedviktar modellen det automatiskt. Denna metod, som behandlas i nyligen genomförda arbeten från Encords ICLR 2026-analys, anses nu vara bästa praxis för produktionsdistributioner.
[UPPLYSNING: Korsmodal uppmärksamhet är den mekanism som gör fusion exakt. Ursprungligen demonstrerad i ViLBERT-arkitekturen (Lu et al., 2019), och förfinad i CLIP och ALIGN, fungerar den genom att beräkna uppmärksamhetspoäng mellan tokens från olika modaliteter – till exempel att justera ordet "spricka" i en underhållsrapport med det specifika område av en röntgenbild där en fraktur uppträder. Träningsdatakvaliteten avgör direkt hur exakt dessa uppmärksamhetsrelationer bildas.]
Steg 3: Avkodare — Producera resultat
Avkodaren genererar modellens utdata: ett textsvar, en avgränsningsruta, en klassificeringsetikett eller en genererad bild. För att avkodaren ska vara tillförlitlig måste fusionslagret ha sett tillräckligt många korrekt justerade exempel under träningen för att lära sig stabila korsmodala associationer.
Detta har en direkt implikation för din datauppsättning: feljusterade par – ett ljudklipp parat med fel transkript, eller en bildtext med en beskrivning av en annan scen – korrumperar fusionslagrets inlärning. Ett felmärkt exempel i en parad datauppsättning orsakar mer skada än ett felmärkt exempel i en unimodal, eftersom det vilseleder två modaliteter samtidigt.
Shaips dataannoterings- och märkningsprocess inkluderar konsistenskontroller mellan olika modala steg i varje steg av just denna anledning.
Det multimodala AI-modelllandskapet 2026
Vilka AI-modeller använder multimodal träningsdata? Varje ledande grundmodell som släppts sedan 2023 är antingen nativt multimodal eller lägger aktivt till modaliteter. GPT-4o, Gemini 2.5, Claude 3.7 Sonnet, Llama 4 Scout och Maverick, och Phi-4 bearbetar alla minst två modaliteter nativt. Att finjustera någon av dem för domänspecifika uppgifter kräver domänspecifik multimodal träningsdata – och det är i den datan som din konkurrensfördel finns.
Så här ser landskapet ut för 2026 utifrån modalitet och implikationer för utbildningsdata:
| Modell | Developer | Kärnmodaliteter | Viktig insikt i träningsdata |
|---|---|---|---|
| GPT-4o | OpenAI | Text, bild, ljud (inbyggt) | Par mellan syn och språk; inbyggt ljud kräver data för justering av tal och text |
| Gemini 2.5 Pro | Google DeepMind | Text, bild, video, ljud, kod | Tränad på sammanflätad multimodal data; stark på långkontextuella video-textuppgifter |
| Claude 3.7 sonett | Antropisk | Text, bild (dokument, diagram) | Optimerad för AI-användningsfall inom dokument; stark på strukturerade bild-text-par |
| Llama 4 Scout / Maverick | meta | Text, bild (sammanflätad) | Öppen vikt; använder sammanflätad bild-text-träning (som i Flamingo) |
| Phi-4 | Microsoft | Text, bild, ljud | Utformad för edge-distribution; effektiv multimodal inferens från kompakta datamängder |
| Qwen2.5-VL | alibaba | Text, bild, video | Stark visuell förståelse; allmänt använd för finjustering med öppen källkod |
Modelllandskapet förändras snabbt. Som ByteByteGo noterar tog eran med textbaserade modeller i praktiken slut år 2025. År 2026 är cirka 60 % av företagsapplikationer byggda med modeller som kombinerar två eller flera modaliteter.
Vad detta innebär för ditt team: själva modellen blir alltmer en handelsvara. Det som skiljer den åt är domänspecifik träningsdata. En generell modell finjusterad på 50 000 högkvalitativa, domänanpassade multimodala exempel från din bransch kommer konsekvent att överträffa en generell modell som används direkt.
Multimodala utbildningsdata per branschvertikal
Olika branscher behöver olika kombinationer av modaliteter. Här är fem vertikaler där multimodal AI har gått från pilotprojekt till produktion – med verifierade offentliga implementeringar.
1. Hälsovård: Kombination av bilddiagnostik, kliniska anteckningar och tal
Google DeepMinds Med-Gemini (2024) visade vad som händer när multimodala träningsdata tas fram i rätt skala. Forskningen, som publicerades i Nature 2024 av Saab et al., visade att en multimodal modell som tränats på medicinska bilder, kliniska anteckningar och patienthistorik signifikant överträffade unimodala baslinjer över 14 medicinska riktmärken – inklusive generering av radiologirapporter och analys av patologiska bilder.
Kraven på träningsdata är strikta: bilddata måste vara DICOM-kompatibla, patientjournaler måste avidentifieras enligt HIPAA-standarder och taldata från läkares diktering måste transkriberas med noggrannhet i medicinsk vokabulär. Shaips katalog över utbildningsdata för hälso- och sjukvård tillhandahåller avidentifierade, HIPAA-kompatibla datamängder för datortomografi, röntgen, magnetresonanstomografi, läkares diktering och elektroniska patientjournaler – byggda specifikt för team som tränar kliniska AI-modeller.
2. Autonoma fordon och robotik: Sensorfusion i stor skala

Teslas helt självkörande system använder data från åtta kameror, ultraljudssensorer och en framåtriktad radar – och bearbetar alla strömmar samtidigt för att fatta körbeslut i realtid. Träningsdatasetet är byggt från miljontals körda kilometer på vägen med annoteringar på bildnivå över varje sensorström.
Waymo och Boston Dynamics (som samarbetar med Google DeepMind kring Gemini Robotics, vilket tillkännagavs på CES 2026) förlitar sig på fusion av LiDAR + kamera + IMU. Som Jensen Huang noterade på CES 2026 representerar fysisk AI – robotar som kombinerar syn, språk och sensorförståelse – nästa stora multimodala frontlinje.
Den gemensamma tråden: dessa system misslyckas när sensormodaliteter inte är synkroniserade till en precision på under en millisekund i träningsdata. Temporär feljustering mellan kamerabilder och LiDAR-svep skapar spökartefakter som modellen lär sig som verkliga funktioner.
3. Detaljhandel och e-handel: Visuell sökning möter naturligt språk
Amazons visuella sökprodukt, StyleSnap, kombinerar bildinbäddningar med textfrågebehandling för att matcha en kunds uppladdade foto mot katalogartiklar. Träningsdata kräver parade bild-text-exempel där de visuella och textuella beskrivningarna är semantiskt likvärdiga – inte bara nyckelordsmatchade.
När produktbilder kommenteras med strukturerade attribut (färg, material, silhuett, stilperiod) och paras ihop med faktiska kundsökningar förbättras konverteringsnoggrannheten avsevärt. Detta är ett problem med AI-datainsamlingens kvalitet, inte modellarkitekturen.
4. Kundupplevelse: Tal, text och känsla tillsammans
Att bygga effektiv träningsdata för detta användningsfall kräver ljudinspelningar med motsvarande transkriptioner, känsloetiketter, avsiktsetiketter och kontextuell metadata – allt kommenterat konsekvent. Komplexiteten i annoteringarna är ungefär tre gånger högre än vid enbart textbaserad avsiktsklassificering.
5. Dokumentera AI och företag: Den snabbast växande vertikalen år 2026

Microsoft Azure Document Intelligence och AWS Textract är de mest använda plattformarna – men båda kräver domänspecifik finjustering för att fungera tillförlitligt på dokumentlayouter som inte är standard. Träningsdata för detta användningsfall kombinerar skannade dokument (bild), extraherad text (OCR), strukturella anteckningar (gränsrutor för fält) och semantiska etiketter (detta fält är "fakturasumma", inte "radpostdelsumma").
Shaips katalog för datorseendedata innehåller datamängder för dokumentbilder som är kommenterade för formuläranalys och layoutförståelse över finansiella, juridiska och hälsovårdsrelaterade dokumenttyper.
Viktiga utmaningar inom multimodal AI-träningsdata
Databrist och obalans
Högkvalitativ, anpassad multimodal data är dyr att samla in och kommentera. Bristen handlar inte bara om total volym. Det handlar om bristen på balanserade, representativa, parade exempel för den exakta affärsuppgiften. Nyligen genomförda benchmarkingstudier visar att multimodal obalans nu är ett erkänt delområde eftersom dominerande modaliteter kan undertrycka signaler från svagare modaliteter.
Justering och synkronisering
Korsmodal justering är fortfarande en av de viktigaste flaskhalsarna inom teknik. I video måste ljud matcha rätt bildintervall. I dokument-AI måste layoutområden mappas korrekt till text och etiketter. Inom sjukvården måste bildbehandling stämma överens med rapporter och strukturerade journaler. Undersökningar om multimodal justering och fusion fortsätter att belysa justering som en central utmaning.
Saknade eller ofullkomliga modaliteter
Verkliga företagssystem får sällan fullständiga indata varje gång. Sensorer går sönder. Samtal har brusigt ljud. Videor kan sakna transkriptioner. Nyligen genomförda undersökningar av ofullkomliga dataförhållanden visar att saknade, korrupta och dåligt anpassade modaliteter fortfarande är en praktisk begränsning för verklig prestanda.
Partiskhet och rättvisa mellan olika modaliteter
Bias försvinner inte i multimodala system. Den förstärks. En undersökning från 2024 om rättvisa och bias inom multimodal AI noterar att biasforskning i stora multimodala modeller fortfarande är mindre mogen än biasforskning inom juridikvetenskap, även om användningen i den verkliga världen expanderar.
Hur multimodal AI-träningsdata fungerar
En stark multimodal pipeline består vanligtvis av fem lager:
1. Datainsamling
Samla in råa resurser från de modaliteter som är relevanta för användningsfallet, såsom bild-text, ljud-text, video-ljud-text eller dokument-bild-text. Stora öppna insatser växer snabbt: Encords E-MM1 beskriver 107 miljoner grupper över fem modaliteter, medan NVIDIA nyligen lyfte fram en 1 700 timmar lång öppen källkodsdatauppsättning för multimodal driving dataset för fysisk AI.
2. Uppriktning
Det här är den svåra delen. Filer måste överensstämma på rätt objekt-, tid- eller dokumentnivå. Justering och sammanslagning är fortfarande stora tekniska utmaningar inom multimodal maskininlärning, och dålig justering försämrar både träningskvaliteten och nedströmshämtning.
3. Anteckning
Annoteringar måste inte bara fånga etiketter inom en modalitet, utan även relationer mellan modaliteter:
- bild – bildtextkonsekvens
- mappning mellan talare och transkript
- tidsstämplar från bildruta till händelse
- dokumentlayout plus extraherad text
- tvärmodala instruktioner och förväntade utdata
4. Kvalitetskontroll
Kvalitetskontroller måste validera synkronisering, fullständighet, rättigheter, språklig noggrannhet och etikettkonsekvens över olika modaliteter. Nytt arbete med multimodal datakvalitetsklassificering visar att semisyntetiska metoder redan används för att kuratera multimodala korpusar av högre kvalitet i stor skala.
5. Utvärdering
Produktionsteam bör utvärdera:
- Noggrannhet i hämtning över olika modaliteter
- jordningskvalitet
- hallucinationsfrekvens
- robusthet mot saknade modaliteter
- rättvisa mellan demografiska grupper och sammanhang

Multimodala AI-utbildningsdata: Viktiga kvalitetskrav
| Kvalitetsdimension | Vad det betyder | Varför det gäller |
|---|---|---|
| Korsmodal anpassning | Ljud, video, text och sensordata synkroniserade till <100ms tolerans | Feljustering producerar systematiska fel i fusionslagret |
| Modalitetsmångfald | Täckning över demografiska grupper, geografiska områden, språk och miljöer | Förhindrar sammansatt bias mellan modaliteter |
| Annoteringskonsistens | Samma semantiska schema tillämpas på alla modaliteter av utbildade annotatörer | Inkonsekventa etiketter producerar inkoherenta korsmodala representationer |
| Täckning av kantfall | Sällsynta händelser och fellägen uttryckligen representerade | Modeller utan edge-case-träning misslyckas tyst i produktion |
| Sekretessefterlevnad | PII borttagen eller syntetiserad; samtycke dokumenterat | Regulatorisk exponering enligt GDPR, HIPAA, EU:s AI-lag |
| Härstamning och proveniens | Fullständig dokumentation av källa, insamlingsmetod, annoteringsversion | Krävs för granskningsbarhet enligt skyldigheter i artikel 10 i EU:s AI-lag |
Hur Shaip stöder multimodal AI-träningsdata i stor skala
Shaip tillhandahåller heltäckande multimodala datatjänster – från anpassad insamling och annotering till färdiga licensierade datamängder – som stödjer företags-AI-team inom hälso- och sjukvård, teknik och e-handel. Vår generativa AI-plattform hanterar multimodala annoteringsarbetsflöden, finjustering av dataförberedelse och RLHF-pipelines över text, tal, bild, video och medicinska bildmodaliteter.
Nyckelfunktioner inkluderar:
- Multimodal datauppsättningsannotering på över 65 språk för tal- och textmodaliteter
- Medicinsk datakatalog inklusive ljud från läkares diktering, transkriberade journaler, röntgen- och datortomografidata och EHR-strukturerade data
- Anpassade datainsamlingstjänster för anpassade audiovisuella, video-text- och dokument-bild-parade dataset
- RLHF och mänskliga feedbackpipelines för finjustering av multimodala grundmodeller
- Efterlevnadsfokuserade arbetsflöden med avidentifiering, samtyckeshantering och fullständig dokumentation av datahärkomst
För företag som bygger multimodal AI i stor skala, snabbar samarbete med en specialiserad dataleverantör upp utvecklingstiderna och säkerställer den annoteringskvalitet som multimodala fusionslager kräver. Utforska Shaips multimodala AI-träningsdatalösningar eller kontakta vårt team för att diskutera ditt användningsfall.
Låt oss prata
Vanliga frågor (FAQ)
1. Vad är multimodal AI?
Multimodal AI är ett artificiellt intelligenssystem som kan bearbeta och förstå mer än en typ av data – såsom text, bilder, ljud och video – samtidigt, snarare än att bara hantera en.
2. Hur skiljer sig multimodal AI från vanlig AI?
Vanlig AI arbetar med en datatyp i taget. Multimodal AI kombinerar flera datatyper, vilket ger en mer fullständig bild – ungefär som hur människor använder syn, hörsel och läsning samtidigt för att förstå världen.
3. Varför är träningsdata så viktiga för multimodal AI?
Modellen kan bara lära sig det som visas. Om träningsdata är ofullständig, feljusterad eller partisk kommer modellen att ge dåliga resultat – oavsett hur avancerad arkitekturen är. Datakvalitet driver modellkvaliteten.
4. Vilka typer av data används för att träna multimodala AI-modeller?
Text, bilder, ljud, video, dokument och sensordata är de vanligaste. Det viktigaste kravet är att dessa datatyper måste paras ihop och justeras – inte samlas in separat.
5. Vad betyder "sammanställda data"?
Sammanpassade data innebär att varje träningsprov har matchande information för alla modaliteter. Till exempel måste ett videoklipp, dess ljudspår och en textbeskrivning alla referera till samma ögonblick och samma betydelse.
6. Kan syntetiska data ersätta verkliga data i multimodal AI-träning?
Inte helt och hållet. Syntetiska data är användbara för att fylla luckor och täcka sällsynta scenarier, men modeller som endast tränas på syntetiska data tenderar att försämras med tiden. En blandning av syntetiska och verkliga, mänskligt annoterade data ger de bästa resultaten.
7. Vilken är den största utmaningen med multimodal AI-träningsdata?
Att samla in korrekt anpassad, tvärmodal data är den svåraste delen. Till skillnad från text, som finns i överflöd online, existerar parad audiovisuell textdata sällan i fritt format och måste vanligtvis skapas avsiktligt.
8. Vad är bortfall av utbildning och varför är det viktigt?
Modalitetsbortfall är en träningsteknik där en eller flera datatyper slumpmässigt tas bort under träning. Detta lär modellen att fortfarande prestera relativt bra även om en modalitet saknas i verklig användning – snarare än att misslyckas helt.
9. Hur mäter man om en multimodal AI-modell presterar bra?
Genom riktmärken som MMMU (för syn och språkförståelse) och Video-MME (för videouppgifter) är det också viktigt att testa för hallucinationer – fall där modellen beskriver saker som inte finns i indata.
10. Vilka branscher gynnas mest av multimodal AI?
Hälsovård, autonoma fordon, detaljhandel och finansiella tjänster ser för närvarande de starkaste resultaten. Alla branscher där beslut bygger på mer än en typ av information är en stark kandidat för multimodal AI.