Om man bara tittar på automatiserade poäng ser de flesta LLM:er bra ut – tills de skriver något subtilt felaktigt, riskabelt eller okonventionellt. Det är gapet mellan vad statiska benchmarks mäter och vad dina användare faktiskt behöver. I den här guiden visar vi hur man kombinerar mänskligt omdöme (HITL) med automatisering så att din LLM-benchmarking återspeglar sanningsenlighet, säkerhet och domänanpassning – inte bara noggrannhet på tokennivå.
Vad LLM-benchmarking verkligen mäter
Automatiserade mätvärden och topplistor är snabba och repeterbara. Noggrannhet i flervalsfrågor, BLEU/ROUGE för textlikhet och förvirring i språkmodellering ger riktlinjer. Men de missar ofta resonemangskedjor, faktabaserade förhållanden och policyefterlevnad – särskilt i sammanhang med höga insatser. Det är därför moderna program betonar multimetrisk, transparent rapportering och scenariorealism.
Automatiserade mätvärden och statiska testuppsättningar
Tänk på klassiska mätvärden som en hastighetsmätare – perfekt för att visa hur fort du kör på en jämn motorväg. Men de visar inte om bromsarna fungerar i regn. BLEU/ROUGE/förvirring hjälper till med jämförbarhet, men de kan manipuleras genom memorering eller matchning på ytan.
Där de kommer till korta
Riktiga användare bidrar med tvetydighet, domänjargong, motstridiga mål och förändrade regler. Statiska testuppsättningar fångar sällan upp detta. Som ett resultat överskattar rent automatiserade riktmärken modellberedskap för komplexa företagsuppgifter. Community-insatser som HELM/AIR-Bench åtgärdar detta genom att täcka fler dimensioner (robusthet, säkerhet, öppenhet) och publicera transparenta, föränderliga sviter.
Argumenten för mänsklig utvärdering i LLM-riktmärken
Vissa egenskaper förblir envist mänskliga: ton, hjälpsamhet, subtil korrekthet, kulturell lämplighet och risk. Mänskliga bedömare – ordentligt utbildade och kalibrerade – är de bästa instrumenten vi har för detta. Tricket är att använda dem selektivt och systematiskt , så att kostnaderna förblir hanterbara medan kvaliteten förblir hög.
När man ska involvera människor
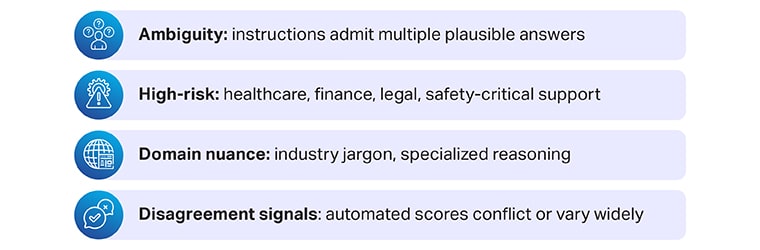
- Tvetydighet: Instruktionerna tillåter flera rimliga svar.
- Högrisk: sjukvård, finans, juridiskt och säkerhetskritiskt stöd.
- Domännyans: branschjargong, specialiserat resonemang.
- Signaler på oenighet: automatiserade poäng motsäger eller varierar kraftigt.
Utforma bedömningsmatriser och kalibrering (enkelt exempel)
Börja med en skala från 1–5 för korrekthet , grundlighet och policyanpassning . Ge 2–3 kommenterade exempel per poäng. Kör korta kalibreringsrundor : bedömare poängsätter en gemensam batch och jämför sedan motiveringar för att öka konsistensen. Spåra överensstämmelse mellan bedömare och kräv bedömning för gränsfall.
Metoder: Från juridikexamen som domare till sann HITL
LLM-as-a-Judge (att använda en modell för att betygsätta en annan modell) är användbart för triage : det är snabbt, billigt och fungerar bra för enkla kontroller. Men det kan dela samma blinda fläckar – hallucinationer, falska korrelationer eller "betygsinflation". Använd det för att prioritera fall för mänsklig granskning, inte för att ersätta det.
En praktisk hybridpipeline
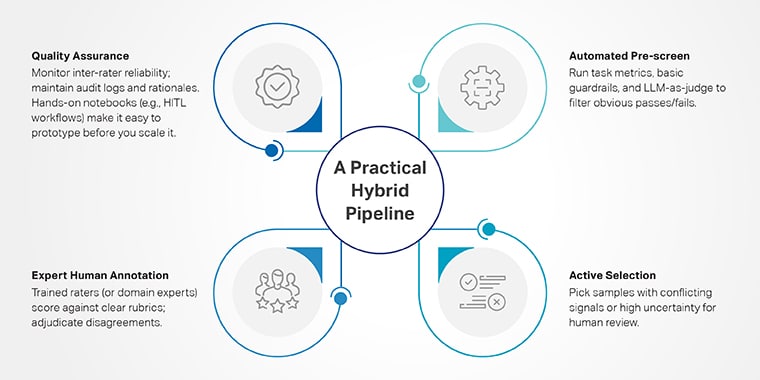
- Automatiserad förhandsgranskning: kör uppgiftsstatistik, grundläggande skyddsräcken och LLM-as-judge för att filtrera bort uppenbara godkända/misslyckade resultat.
- Aktivt val: välja prover med motstridiga signaler eller hög osäkerhet för mänsklig granskning.
- Expert mänsklig annotering: utbildade bedömare (eller domänexperter) poängsätter utifrån tydliga matriser; avgör oenigheter.
- Kvalitetssäkring: övervaka tillförlitlighet mellan bedömare; underhålla revisionsloggar och motiveringar. Praktiska anteckningsböcker (t.ex. HITL-arbetsflöden) gör det enkelt att prototypa denna loop innan du skalar den.
Jämförelsetabell: Automatiserad vs. LLM-som-domare vs. HITL
Säkerhets- och riskmått är olika
Tillsynsmyndigheter och standardiseringsorgan förväntar sig utvärderingar som dokumenterar risker, testar realistiska scenarier och visar tillsyn. NIST AI RMF (2024 GenAI Profile) tillhandahåller ett gemensamt vokabulär och praxis; NIST GenAI Evaluation- programmet stöder domänspecifika tester; och HELM/AIR-Bench belyser multimetriska, transparenta resultat. Använd dessa för att förankra er styrningsberättelse.
Vad som ska samlas in för säkerhetsrevisioner
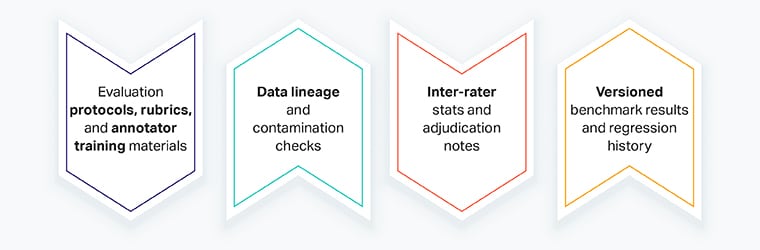
- Utvärdering protokoll, rubrikeroch annotatorutbildning material
- Datalinje och kontamineringskontroller
- Inter-bedömare statistik och bedömningsanteckningar
- Versionsbaserad riktmärkesresultat och regressionshistorik
Miniberättelse: Minska falska positiva resultat i bank-KYC
En banks KYC-analytikerteam testade två modeller för att sammanfatta compliance-aviseringar. De automatiserade poängen var identiska. Under ett HITL-godkännande flaggade bedömarna att modell A ofta utelämnade negativa kvalificeringar ("inga tidigare sanktioner") och vände på betydelserna. Efter bedömningen valde banken modell B och uppdaterade uppmaningarna. Falska positiva resultat minskade med 18 % på en vecka, vilket frigjorde analytikerna för riktiga undersökningar. (Lärdomen: automatiserade poäng missade ett subtilt fel med stor inverkan; HITL upptäckte det.)
Där Shaip hjälper
- Ordlista och utbildning: Enkel förklaring av "human-in-the-loop" och varför det är viktigt för GenAI.
- Instruktioner och strategi: A Nybörjarguide till LLM-utvärdering för lag som börjar från början.
- Plattform: A Generativ AI-utvärderings- och övervakningsplattform att operationalisera triage, experiment och revisioner.